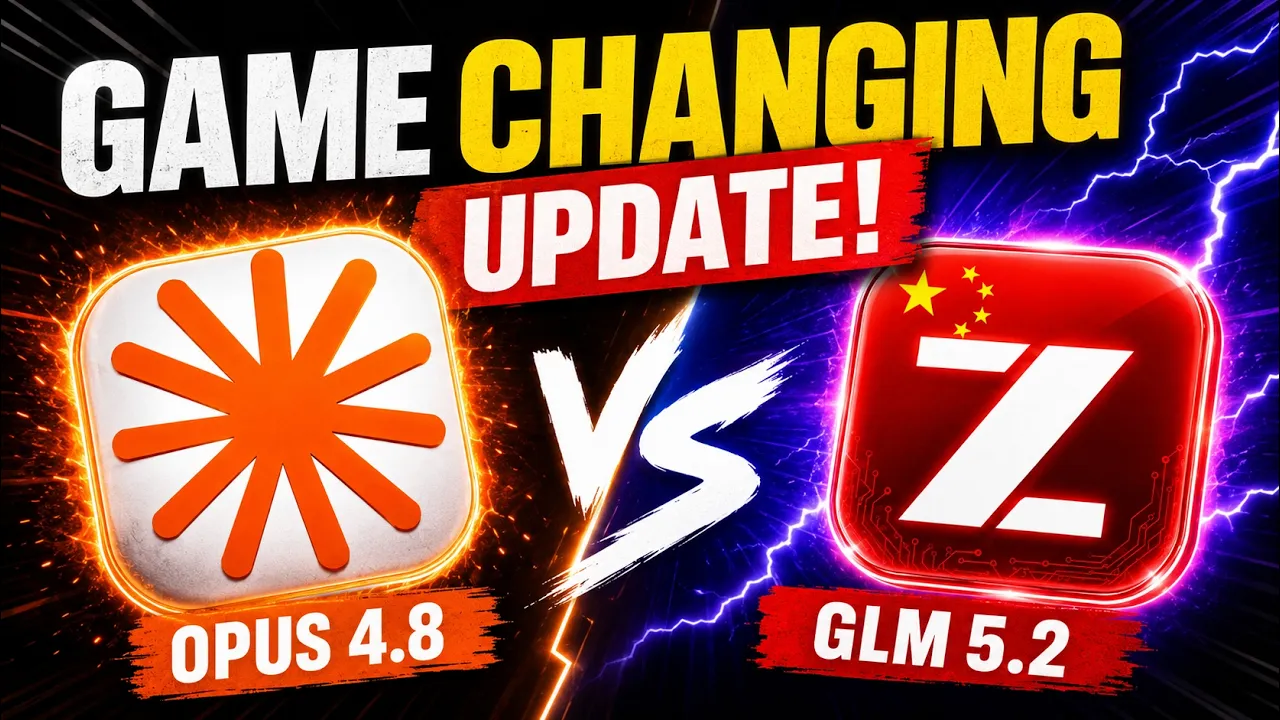
GLM-5.2 vs. Claude Opus 4.8: Das Open-Source-Erdbeben
753 Milliarden Parameter. MIT-Lizenz. 1 Million Token Kontext. Und ein Preis, der Claude Opus 4.8 auf einmal teuer aussehen lässt: 5,7-mal günstiger pro Output-Token. Z.ais GLM-5.2 ist nicht nur das stärkste Open-Weight-Modell 2026 – es ist die lauteste Ansage, die China je in Richtung westlicher KI-Labs gemacht hat.
BenchLM Gesamtranking
GLM-5.2
Z.ai (Zhipu)
94
Punkte
🥇 #1 Gesamt
VS
Claude Opus 4.8
Anthropic
93
Punkte
🥈 #2 Gesamt
Quelle: BenchLM.ai Provisional Leaderboard · Juni 2026
753B
Parameter (MoE) · ~40B aktiv pro Token
5,7×
Günstiger als Claude Opus 4.8 pro Output-Token
1M
Token Kontextfenster · 5× mehr als GLM-5.1
MIT
Lizenz · Vollständig Open Source · HuggingFace
Alle zwei Wochen gibt es ein neues „bestes Open-Source-Modell“. Diesmal ist es anders. GLM-5.2 steht auf Platz 1 des unabhängigen Artificial Analysis Intelligence Index – mit einem Score von 51, vor MiniMax-M3, DeepSeek V4 Pro (beide 44) und Kimi K2.6 (43). Aber mehr noch als die Leistungszahlen ist es die Kombination, die diese Woche elektrisiert: Frontier-nahes Coding, MIT-Lizenz, 1-Millionen-Token-Kontext – und ein Preis, der die westlichen Closed-Source-Flaggschiffe nicht nur günstiger, sondern fundamental in Frage stellt. Dieser Artikel liefert den vollständigen Faktencheck.
01
Was ist GLM-5.2? – Architektur, Herkunft, Timing

Z.ai, Zhipu AI und das 753-Milliarden-Parameter-Modell aus Tsinghua
GLM-5.2 ist das neueste Flagship-Modell von Zhipu AI – einem Pekinger KI-Labor, das 2019 aus der Tsinghua University hervorgegangen ist und international unter dem Namen Z.ai auftritt. Das Unternehmen notierte im Januar 2026 an der Hongkonger Börse – als erster großer chinesischer LLM-Hersteller überhaupt. Am 13. Juni 2026 erschien GLM-5.2 zunächst für zahlende Abonnenten des GLM Coding Plans. Drei Tage später, am 16. Juni, öffnete Z.ai die vollständigen Gewichte unter MIT-Lizenz auf HuggingFace – für jeden, ohne regionale Einschränkungen, vollständig kommerziell nutzbar.
Das Timing war nicht subtil: GLM-5.2 erschien zwei Tage, nachdem die USA Anthropic angewiesen hatten, ausländischen Zugang zu seinen Fable-5- und Mythos-5-Modellen zu beschränken. Für Entwickler weltweit, die plötzlich vom leistungsstärksten Anthropic-Modell ausgeschlossen wurden, war GLM-5.2 keine akademische Neuigkeit – es war eine Ausweichoption.
🔧 GLM-5.2 Technische Spezifikationen – Vollständig
Architektur
Mixture-of-Experts (MoE)
~753B Total-Parameter · ~40B aktiv pro Token
Kontext
1.000.000 Tokens
5× mehr als GLM-5.1 (200K) · via glm-5.2[1m] Model-ID
Max. Output
131.072 Tokens
Vollständige Repository-Refaktors in einem Durchlauf möglich
Lizenz
MIT Open Source
Vollständig kommerziell · Selbst-Hosting erlaubt · HuggingFace: zai-org/GLM-5.2
Reasoning-Modi
High & Max
High: schnell · Max: tiefes Reasoning für komplexe Multi-Step-Aufgaben
Architektur-Trick
IndexShare
Sparse-Attention Top-K Indices über Layer-Gruppen geteilt → günstigere 1M-Token-Inferenz
Pretraining
28,5 Billionen Tokens
Massive Trainingsskala · Grundlage der starken Reasoning-Leistung
Modalität
Text-only
Kein Vision-Support – Hauptkritikpunkt von Jeremy Howard (fast.ai)
Release-Datum
13./16. Juni 2026
Soft Launch 13.06. · Open Weights + API + Benchmarks: 16.06.2026
02
Die Benchmark-Wahrheit – Was GLM-5.2 wirklich schlägt (und was nicht)
94 vs. 93 Punkte: GLM-5.2 führt knapp – aber der Vorsprung hängt vom Benchmark ab
Auf BenchLMs provisorischem Gesamtleaderboard liegt GLM-5.2 mit 94 Punkten vor Claude Opus 4.8 mit 93 Punkten. Das ist genug, um zu gewinnen – aber nicht genug für einen Knockout. GLM-5.2s schärfster Vorteil liegt im Agentic-Bereich, wo es im Schnitt 81 gegen 80,1 erzielt. Der einzige bedeutende Swing auf dem Board ist SWE-bench Pro: 69,2 % zu 62,1 %.
Auf den herausforderndsten Agentic-Benchmarks hält Claude Opus 4.8 die Führung: NL2Repo (69,7 vs. 48,9), SWE-Marathon (26,0 vs. 13,0) und Tool-Decathlon (59,9 vs. 48,2). GLM-5.2 schließt auf bis auf einen Punkt auf FrontierSWE (74,4 vs. 75,1) und MCP-Atlas (76,8 vs. 77,8) – und gewinnt outright bei AIME 2026, IMOAnswerBench und Terminal-Bench 2.1 unter seinem besten Harness.
📊 GLM-5.2 vs. Claude Opus 4.8 vs. GPT-5.5 – Benchmark-Matrix Juni 2026
■ GLM-5.2
■ Claude Opus 4.8
■ GPT-5.5
SWE-bench Pro
Real-World Software Engineering
FrontierSWE
Multi-Hour Open-Source Projects
Terminal-Bench 2.1
Autonomes Terminal Coding
AIME 2026
Mathematische Olympiade
MCP-Atlas
Tool Use & Agent Workflows
NL2Repo
Repository aus Spec bauen
⚠️ Alle Z.ai-Zahlen sind vendor-selbst-berichtet und noch nicht vollständig unabhängig verifiziert. Quellen: Z.ai Technical Report · BenchLM.ai · LLM-Stats.com · VentureBeat · Juni 2026
MIA
Mia – IT REX Solutions
Kostenlose Erstberatung – unverbindlich & persönlich
Ob Managed IT, Cloud-Migration, KI-Infrastruktur oder IT-Sicherheit – wir finden die richtige Lösung für Ihr Unternehmen. Sprechen Sie uns einfach an.
🥇 #1
Claude Fable 5 (High)
Anthropic · Derzeit nicht aktiv in Arena
🥈 #2
GLM-5.2 (Max)
Z.ai · Schlägt Claude Opus 4.7 & Opus 4.8 im Thinking Mode
🥉 #3
Claude Opus 4.8
Anthropic · Thinking Mode
Ein Leaderboard, das auf blinden paarweisen menschlichen Abstimmungen aufbaut, ist schwer zu manipulieren und unabhängig vom Anbieter. Das macht GLM-5.2s Platz 2 bedeutsamer als jede Zahl in Z.ais eigenem Benchmark-Bericht.
„GLM-5.2 ist mindestens so gut wie Opus 4.8 und GPT 5.5 für meinen Einsatz – und es ist ein Wunder, dass es MIT-lizenziert ist.“
— Jeremy Howard, Gründer fast.ai, auf X, 17. Juni 2026
03
Der eigentliche Killer: Preis – 5,7× günstiger als Claude Opus 4.8
$4,40 vs. $25,00 pro Million Output-Tokens – das ist keine Preisdifferenz, das ist eine andere Liga
GLM-5.2s API, live seit dem 16. Juni 2026, kostet $1,40 pro Million Input-Tokens und $4,40 pro Million Output-Tokens. Claude Opus 4.8 kostet $5,00 pro Million Input und $25,00 pro Million Output. GPT-5.5 liegt bei $5/$30. Das ist ein 5- bis 7-facher Abstand bei Output-Tokens allein – und rund ein Sechstel der gemischten Kosten von GPT-5.5.
Smarteste Teams führen Opus 4.8 für die 20 % der Aufgaben, bei denen der Benchmark-Abstand wirklich zählt – und GLM-5.2 für die anderen 80 %. Bei $440 vs. $2.500 pro 100 Millionen Output-Tokens ist die Rechnung einfach.
💰 API-Preis-Vergleich · Stand: 16. Juni 2026
🟢 GLM-5.2
Z.ai (Zhipu)
$1,40
$4,40
$440
✓ MIT
🟠 Claude Opus 4.8
Anthropic
$5,00
$25,00
$2.500
✗ Closed
⚪ GPT-5.5
OpenAI
$5,00
$30,00
$3.000
✗ Closed
🆓 Self-Hosted
$0 / Monat
MIT-Gewichte · HuggingFace · eigene Hardware
⚠️ 1,51 TB Gewichte · ~8× 96GB GPUs nötig
Beliebt
💼 Coding Plan Lite
$10 / Monat
Flat Subscription · Coding-Tool-Integration
Pro: $30 · Max: $80 · Team verfügbar
📡 Metered API
$1,40 / $4,40
Input / Output pro Million Tokens
⚠️ API-Server in China · NI-Gesetz beachten
04
Der eigentliche Sieg von GLM-5.2 – und was er für die Industrie bedeutet
Das erste Open-Weight-Modell, das Opus 4.8 teuer aussehen lässt, ohne es langsam aussehen zu lassen
GLM-5.2 ist das erste Open-Weight-Modell, das Claude Opus 4.8 teuer aussehen lässt – ohne es langsam aussehen zu lassen. Frühere Open-Source-Modelle waren entweder günstig aber schwach, oder stark aber proprietär verpackt. GLM-5.2 ist das erste, das gleichzeitig an der Frontier-Leistungsgrenze kratzt und vollständig für Selbsthosting und kommerzielle Nutzung freigegeben ist.
Graham Neubig von der Carnegie Mellon University schrieb auf X: GLM-5.2 ist „wahrscheinlich das erste Modell, das gut genug ist, um Closed-Source-Modelle vollständig aus dem Workflow zu ersetzen.“ Das ist eine starke These – und sie ist nicht unbegründet.
🎯 Wann GLM-5.2 wählen – Wann Claude Opus 4.8 wählen
💰 Kosten das primäre Kriterium sind – 5–7× günstiger
🔓 Open Weights für Selbst-Hosting benötigt werden
📐 Mathematik-lastige Tasks (AIME 2026: 99,2 %)
🖥️ Frontend-Generierung (Design Arena #1 weltweit)
📁 Gesamte Repositories im Kontext (1M Token)
🤖 High-Volume-Agentic-Pipelines
🔧 Fine-Tuning auf proprietären Codebasen (MIT)
🧮 SWE-bench Pro Benchmark (62,1 % – schlägt GPT-5.5)
🏗️ Maximale Long-Horizon SWE-Tiefe (NL2Repo: 69,7)
🔒 Datenschutz & regulierte Branchen (kein China-Routing)
🧠 Breitestes Expertenwissen (GPQA, HLE)
⚙️ Tool-Decathlon / Komplexe Toolchains (59,9)
🛠️ Etabliertes Ecosystem: Claude Code Harness
🖼️ Vision-Tasks (GLM-5.2 ist text-only)
🏢 Enterprise-Compliance ohne China-Serverrisiko
📜 SWE-Marathon (26,0 vs. 13,0 – doppelt so stark)
05
Das, was niemand sagt – Risiken und Realitäts-Check
China-Serverrisiko, 1,51 TB Gewichte und vendor-berichtete Benchmarks
🔴 Hoch
China National Intelligence Law
Wenn du Z.ais gehostete API verwendest, laufen Prompts und Code über Server, die dem chinesischen Nationalen Geheimdienstgesetz unterliegen – das chinesische Unternehmen zur Kooperation mit Regierungsanfragen verpflichtet. Für regulierte Branchen (Healthcare, Finance, Defense, Government) ist das ein No-Go.
🔴 Prüfen
Vendor-Selbst-Berichtete Benchmarks
Z.ai veröffentlichte bei Launch keine Benchmarks – und die Zahlen, die später erschienen, sind vendor-selbst-berichtet und noch nicht vollständig durch unabhängige Dritte verifiziert. Behandle Leaderboard-Zahlen als Behauptungen bis zur externen Bestätigung.
🟡 Wichtig
Hardware-Realität: 1,51 TB Gewichte
GLM-5.2 lokal zu betreiben bedeutet etwas sehr Spezifisches: Die Gewichte sind 1,51 TB groß. Ein Entwickler errechnete, dass man ca. acht 96-GB-Blackwell-GPUs benötigt – rund $150.000. „Self-hosting“ ist eine Datacenter-Entscheidung, kein Wochenend-Projekt.
🟡 Beachten
Entity List & US-Kongressanfrage
Das US Bureau of Industry and Security fügte Zhipu AI im Januar 2025 zur Entity List hinzu. Im Mai 2026 eröffneten US-Abgeordnete eine formale Untersuchung zu Cybersicherheitsrisiken durch PRC-KI-Modelle in kritischer Infrastruktur.
🟢 Niedrig
Kein Vision-Support
GLM-5.2 ist text-only. Jeremy Howard nannte das als einzigen signifikanten Gap. Für multimodale Workflows bleibt Claude Opus 4.8 oder GPT-5.5 die Wahl.
🟢 Zu Prüfen
Quota-Verbrauch bis 3×
Der GLM Coding Plan verbraucht Quota in Spitzenstunden bis zu dreifach – was höhere Nutzung schwer vorherzusagen macht. Genaue Preise über dem Entry-Tier sind nicht publiziert.
„Wenn die Leistungslücke auf 10 % schrumpft, die Kostenlücke 6× beträgt und eines Open Source ist – werden Entwickler mit den Füßen abstimmen. In einem Jahr werden wir wissen, wer richtig gewettet hat.“
— StableLearn, Analyse zu GLM-5.2 Open-Source-Release, 17. Juni 2026
06
Was die Community sagt – Entwickler-Reaktionen aus erster Hand
Das Fazit
GLM-5.2 ist nicht der Totschläger von Claude Opus 4.8. Es ist etwas Präziseres und Interessanteres: das erste Open-Weight-Modell, das die Frage vom „Ob“ zum „Wann und Wie“ verschiebt. BenchLM sagt 94 zu 93 – das ist nah genug, dass das Preisschild die Entscheidung trifft. Bei 5,7-fach günstigeren Output-Kosten, MIT-Lizenz und einem 1-Millionen-Token-Kontextfenster, das tatsächlich funktioniert, gibt es für 80 % aller Coding-Workflows keinen rationalen Grund mehr, das teurere Modell zu wählen. Für die anderen 20 % – lange agentic Horizonte, multimodale Tasks, regulierte Branchen ohne China-Server – bleibt Claude Opus 4.8 unerreicht. Aber der Markt hat gesprochen: GLM-5.2 hat mit einem einzigen Modell-Release die Messlatte für „gut genug“ dauerhaft neu gesetzt.
FAQ – GLM-5.2 vs. Claude Opus 4.8
Schlägt GLM-5.2 wirklich Claude Opus 4.8?
Es kommt auf den Benchmark an. Auf BenchLMs provisorischem Gesamtleaderboard liegt GLM-5.2 mit 94 zu 93 Punkten knapp vorne. Im Agentic-Bereich führt GLM-5.2 im Schnitt (81 vs. 80,1). Claude Opus 4.8 führt klar bei NL2Repo (69,7 vs. 48,9), SWE-Marathon (26,0 vs. 13,0) und Tool-Decathlon. Auf Design Arena und LMArena Code Arena liegt GLM-5.2 (Max) auf Platz 2 hinter Claude Fable 5 und vor Opus 4.8. Kein eindeutiger Gewinner – sondern verschiedene Stärken für verschiedene Aufgaben.
Was ist der Preisunterschied zwischen GLM-5.2 und Claude Opus 4.8?
GLM-5.2 kostet $1,40 pro Million Input-Tokens und $4,40 pro Million Output-Tokens. Claude Opus 4.8 kostet $5,00 Input und $25,00 Output. Das ist eine 5- bis 7-fache Kostendifferenz bei Output-Tokens – oder $440 vs. $2.500 pro 100 Millionen Output-Tokens. Zusätzlich gibt es GLM Coding Plan Flat-Abos ab $10/Monat.
Ist GLM-5.2 wirklich Open Source?
Die Gewichte sind unter MIT-Lizenz verfügbar – vollständig kommerziell nutzbar, ohne regionale Einschränkungen, auf HuggingFace unter zai-org/GLM-5.2. Allerdings: Trainings-Code und Daten-Rezept sind nicht veröffentlicht. „Open Weights“ ist präziser als „Open Source“. Und Selbst-Hosting erfordert erhebliche Hardware: 1,51 TB Gewichte, ca. 8× 96-GB-GPUs (~$150.000).
Ist es sicher, GLM-5.2 API zu nutzen?
Das hängt vom Anwendungsfall ab. Die gehostete Z.ai-API leitet Prompts über Server, die dem chinesischen Nationalen Geheimdienstgesetz unterliegen. Für regulierte Branchen, proprietären Code oder Kundendaten: kritisch. Für öffentliche oder nicht-sensitive Daten mit Selbst-Hosting auf eigener Infrastruktur: kein Problem. Z.ai steht auf der US Entity List seit Januar 2025.
Welche Coding-Tools sind mit GLM-5.2 kompatibel?
GLM-5.2 ist kompatibel mit Claude Code, Cline, Kilo Code, OpenClaw, Goose und Roo – den wichtigsten Agentic-Coding-Frameworks. Das macht den Wechsel für Teams, die bereits mit diesen Tools arbeiten, besonders reibungslos.
Was ist der Unterschied zwischen GLM-5.1 und GLM-5.2?
Der wichtigste Unterschied ist das Kontextfenster: 200.000 Tokens (GLM-5.1) vs. 1.000.000 Tokens (GLM-5.2) – eine 5-fache Steigerung. SWE-bench Pro verbesserte sich von 58,4 auf 62,1. Terminal-Bench 2.1 sprang von 63,5 auf 81,0 – ein Zuwachs von über 27 Prozentpunkten. Neu: IndexShare-Architektur für günstigere 1M-Token-Inferenz, sowie High/Max Reasoning-Modi.
GLM-5.2
Claude Opus 4.8
Z.ai Zhipu AI
Open Source KI
KI Benchmark 2026
LLM Vergleich
MIT Lizenz KI
Agentic Coding
GPT-5.5
MoE Modell
SWE-bench
 061318944180