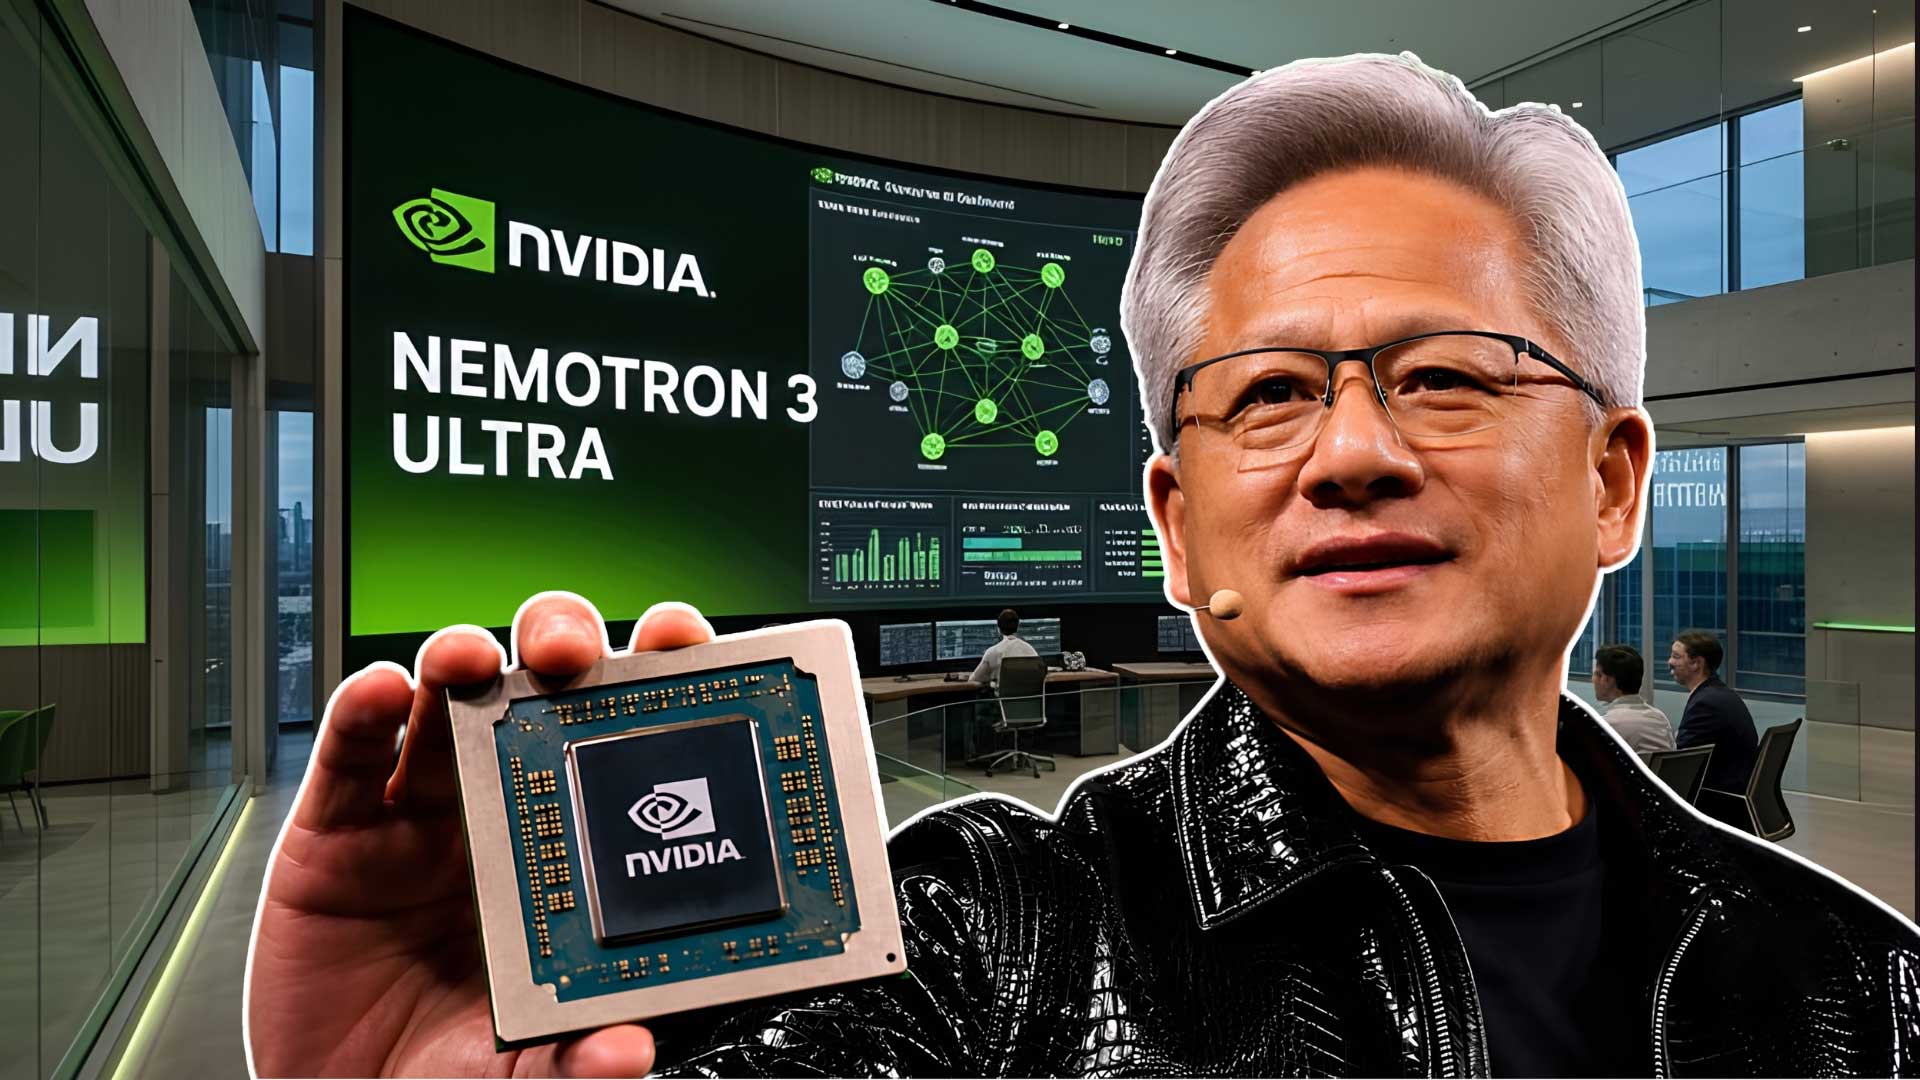
NVIDIA Nemotron 3 Ultra: Stärkstes US-Open-Source-Modell
550 Milliarden Parameter. 1-Million-Token-Kontext. $0 per Token über OpenRouter. NVIDIA hat mit Nemotron 3 Ultra das leistungsstärkste Open-Weight-Modell der USA veröffentlicht – und es schlägt Claude Opus 4.8 in Throughput, Agentic-Effizienz und Preis gleichzeitig. Jensen Huang nannte es „frontier smart“. Wir sagen: Es ist das überzeugendste kostenlose Modell, das Entwickler 2026 nutzen können.
🥇 #1 US Open-Weight
Nemotron 3 Ultra
47,7
NVIDIA · Open · Kostenlos
vs.
Vorheriger US-Führer
Gemma 4 31B
39,2
Google · Open
Quelle: Artificial Analysis Intelligence Index · Juni 2026
550B
Total Parameter (MoE) · 55B aktiv pro Token
5×
Höherer Throughput vs. vergleichbare Open-Weight-Modelle
1M
Token Kontextfenster · 400+ Tokens/Sekunde · $0 auf OpenRouter
−30 %
Geringere Kosten pro Agent-Task vs. vergleichbare Modelle
NVIDIA Nemotron 3 Ultra ist ein Open-Frontier-Reasoning- und Orchestrierungsmodell von NVIDIA, mit 55 Milliarden aktiven Parametern aus 550 Milliarden Gesamt-Parametern (MoE). Es wurde am 4. Juni 2026 veröffentlicht und unterstützt ein Kontextfenster von bis zu 1 Million Tokens. Für Entwickler, die bisher zwischen teuren Closed-Source-Flaggschiffen wie Claude Opus 4.8 oder GPT-5.5 wählen mussten, ist Nemotron 3 Ultra ein Paradigmenwechsel: Frontier-nahes Reasoning, vollständig open source, mit einer kostenlosen API über build.nvidia.com und OpenRouter – ohne Kreditkarte, ohne monatliches Abo.
01
Technische Spezifikationen – Was in Nemotron 3 Ultra steckt
550 Milliarden Parameter, nur 55 Milliarden aktiv – das Geheimnis der MoE-Effizienz
🔧 Nemotron 3 Ultra – Vollständige Technische Spezifikationen
Parameter
550B total · 55B aktiv
Mixture-of-Experts: ~10 % der Parameter aktiv pro Forward-Pass → dramatisch effizienter als Dense-Modelle
Kontextfenster
1.000.000 Tokens
Gesamte Codebases, lange Dokumente, Multi-Turn-Agent-Historien in einem einzigen Kontext
Max. Output
65.536 Tokens
Via OpenRouter (Free) · NVIDIA Build API: bis 131.072 Tokens
Inference Speed
400+ Tokens/Sek.
Via Blackbox AI Endpoint · 5× schneller als GLM-5.1-754B · 4,8× vs. Kimi-K2.6
Architektur
Hybrid Mamba-Transformer MoE
LatentMoE + Multi-Token Prediction + NVFP4 Quantization für Blackwell-GPUs
Lizenz
NVIDIA Open License
Open Weights + Trainings-Rezepte + Datasets · HuggingFace: nvidia/nemotron-3-ultra-550b-a55b
Pretraining
Nemotron-CC + 173B Code Tokens
GitHub Code bis Sept. 2025 · Legal + Specialized Datasets · Vollständig transparent
Reasoning Modi
High & Max
Inference-Time Budget Control · enable_thinking + reasoning_budget Parameter steuerbar
Quantisierung
NVFP4 (empfohlen)
NVIDIA-eigenes FP4-Format · minimal Qualitätsverlust (47,7 vs. 48,2 auf BF16) · viel höherer Throughput auf Blackwell
Modalität
Text (Nano Omni: +Vision)
Ultra: Text-only · Nano Omni: Text + Bild + Video + Audio für multimodale Sub-Agenten
Deployment
vLLM · SGLang · NIM
Ollama + llama.cpp für Edge · NVIDIA NIM Microservices für Enterprise · Self-Hosting möglich
Release
4. Juni 2026
Angekündigt: Computex 2026 Taipeh · Soft-Release: 4. Juni · Open Weights: parallel mit API
02
Architektur-Innovationen – Was Nemotron 3 Ultra technisch einzigartig macht
Hybrid Mamba-Transformer, LatentMoE und NVFP4 – warum diese Kombination neu ist
Pure Transformer-Modelle sind leistungsstark, aber memory-hungry bei langem Kontext. Pure State-Space-Modelle wie Mamba sind memory-effizient, haben aber bekannte Accuracy-Ceilings bei komplexen Reasoning-Tasks. Nemotron 3 Ultra kombiniert beide: Transformer-Layer für Reasoning-Präzision, Mamba-Layer für effiziente Langkontext-Verarbeitung.
🔀
Hybrid Mamba-Transformer MoE
Kombiniert Transformer-Reasoning mit Mamba-SSM-Effizienz. Transformer-Layer übernehmen komplexe Aufmerksamkeit, Mamba-Layer verwalten langen Kontext ohne quadratischen Speicherbedarf. Ergebnis: 1 Million Token-Kontext ohne Latenz-Explosion.
Kernarchitektur
🎯
LatentMoE Expert Routing
LatentMoE ermöglicht das Aufrufen von 4 Experten für die Inferenzkosten von nur einem, was Intelligenz und Generalisierung verbessert. Kombiniert mit Latent-Space-Routing für präzisere Expert-Auswahl als Standard MoE.
Effizienz-Innovation
⚡
Multi-Token Prediction (MTP)
MTP-Layer ermöglichen native Speculative Decoding – das Modell sagt mehrere Tokens gleichzeitig voraus und validiert sie parallel. Das senkt die durchschnittliche Latenz pro Token und erhöht den effektiven Throughput deutlich.
Geschwindigkeits-Boost
🔢
NVFP4 Quantization
NVIDIA pretrainiert Nemotron 3 Ultra nativ in NVFP4 – einem proprietären 4-Bit-Format optimiert für Blackwell-GPUs. Das ermöglicht bis zu 5× höheren Throughput auf Blackwell-Hardware bei minimalem Qualitätsverlust: 47,7 (NVFP4) vs. 48,2 (BF16) auf dem Intelligence Index.
Hardware-Optimierung
🎓
Multi-Teacher Distillation (MOPD)
Multi-Teacher On-Policy Distillation (MOPD) trainiert Nemotron 3 Ultra mit dichtem Feedback von über zehn domänenspezifischen Teacher-Modellen. Das ermöglicht kontinuierliche Verbesserung und Domänen-Spezialisierung ohne vollständiges Retraining.
Training-Innovation
🎮
Multi-Environment RL
Reinforcement Learning über mehr als 10 Umgebungen gleichzeitig – inkl. SWE-RL für Software-Engineering. Das ist NVIDIAs erstes Modell, das in echten Code-Agent-Umgebungen post-trainiert wurde, nicht nur auf synthetischen Daten.
Agentic Training
03
Benchmarks – Was Nemotron 3 Ultra wirklich kann (und was nicht)
47,7 Punkte auf dem Intelligence Index – bestes US-Open-Weight-Modell, aber hinter chinesischen Modellen
Nemotron 3 Ultra führt mit 47,7 Punkten klar auf dem Intelligence Index – weit vor dem nächststärksten US-Open-Weight-Modell Gemma 4 31B (39,2), Nemotron 3 Super (36,0) und GPT-OSS-120B (33,3), aber hinter der chinesisch geführten Open-Weight-Frontier (Kimi K2.6 bei 53,9). Der ehrliche Befund: NVIDIA hat die US-Open-Weight-Lücke signifikant geschlossen – aber noch nicht ganz.
📊 Nemotron 3 Ultra Benchmark-Matrix – Juni 2026
Intelligence Index (AA)
47,7
~93 (proprietär)
53,9
🥇 #1 US Open
PinchBench Agentic
90 % Median
~85 %
90 %
🤝 Auf Augenhöhe
Inference Speed
400+ Tok/s
~120 Tok/s
~180 Tok/s
🥇 Klar führend
SWE-bench Verified
~62 %
~69 %
~65 %
🥈 Claude führt
Terminal-Bench 2.0 (Effizienz)
−30 % weniger Tokens
Baseline
Baseline
🥇 Effizienz-Sieger
RULER 1M (Long Context)
95 %
–
–
🥇 Einzigartig
AA-Omniscience Non-Hallucination
71 %
–
–
✅ Stark
CritPt (Physik-Forschung)
3 %
–
–
⚠️ Schwäche
Agentic Kosten-Effizienz
−30 % vs. Peers
Baseline
Ähnlich
🥇 Kostenführer
⚠️ Alle Werte: Artificial Analysis · NVIDIA Technical Blog · Kilo Code PinchBench · Juni 2026. Claude Opus 4.8 Zahlen: BenchLM Gesamtindex, nicht direkt auf AA-Index umrechnbar.
⚡
Throughput-Vergleich – Warum Geschwindigkeit bei Agenten entscheidet
Nemotron 3 Ultra erzielt 5,9× höheren Inference-Throughput verglichen mit GLM-5.1-754B-A40B, 4,8× höher als Kimi-K2.6-1T-A32B und 1,6× höher als Qwen-3.5-397B-17B im 8K-Input / 64K-Output-Setting. Bei langen Agenten-Aufgaben ist Throughput nicht Komfort – er ist der Faktor, der über Kosten und User-Experience entscheidet.
04
Nemotron 3 Ultra vs. Claude Opus 4.8, GPT-5.5 und GLM-5.2 – Der ehrliche Vergleich

5,7× günstiger als Claude Opus 4.8, 5× schneller – aber bei welchen Tasks verliert Nemotron?
$0 / API (OpenRouter)
✓ $0 per Token (OpenRouter Free)
✓ 400+ Tokens/Sek. Throughput
✓ 1M Token Kontext
✓ Open Source · Self-Hosting möglich
✓ −30 % Kosten bei Agentic Tasks
✓ PinchBench: #1 Open Agentic
✓ Kein Datenschutz-Risiko bei Self-Host
✗ Text-only (kein Vision)
✗ SWE-bench hinter Claude Opus 4.8
✗ Physik-Research-Benchmark schwach
✗ Self-Hosting erfordert 8× 96GB GPUs
$25 / 1M Output-Tokens
✓ SWE-bench Verified: ~69 % (führend)
✓ NL2Repo: 69,7 % (klar besser)
✓ SWE-Marathon: 26,0 % (doppelt so stark)
✓ Tool-Decathlon: 59,9 %
✓ Vision-Support (Multimodal)
✓ Reifes Ökosystem (Claude Code etc.)
✓ Höchste Enterprise-Revenue-per-User
✗ $25/1M Output-Token (5,7× teurer)
✗ ~120 Tok/s (3,3× langsamer)
✗ Closed Source · kein Self-Hosting
✗ Datenschutzrisiko bei sensiblen Daten
$4,40 / 1M Output-Tokens
✓ MIT-Lizenz (noch offener als NVIDIA)
✓ BenchLM Gesamtranking: 94 Pkt.
✓ AIME 2026: 99,2 %
✓ 1M Token Kontext
✓ SWE-bench Pro: 62,1 %
✗ API-Server in China (Datenschutz)
✗ US Entity List (Zhipu AI)
✗ Nicht vollständig unabh. verifiziert
✗ Kein Vision-Support
MIA
Mia – IT REX Solutions
Kostenlose Erstberatung – unverbindlich & persönlich
Ob Managed IT, Cloud-Migration, KI-Infrastruktur oder IT-Sicherheit – wir finden die richtige Lösung für Ihr Unternehmen. Sprechen Sie uns einfach an.
⚔️ Vollständiger Modell-Vergleich: Nemotron 3 Ultra vs. alle
Preis (Output/1M)
$0 (Free) / $2,20 (Paid)
$25,00
$30,00
$4,40
Throughput
400+ Tok/s 🥇
~120 Tok/s
~100 Tok/s
~200 Tok/s
Kontextfenster
1M Token
200K Token
128K Token
1M Token
Open Source
✓ NVIDIA Open License
✗ Closed
✗ Closed
✓ MIT
Vision-Support
✗ Text-only
✓ Multimodal
✓ Multimodal
✗ Text-only
Self-Hosting
✓ (erfordert ~8× 96GB GPUs)
✗ API-only
✗ API-only
✓ MIT · HuggingFace
Datenschutz-Risiko
Gering (US-Unternehmen)
Mittel (Cloud-API)
Mittel (Cloud-API)
Hoch (China-Server)
Agentic Kosten
−30 % vs. Peers 🥇
Baseline
Höher
Ähnlich
PinchBench Score
90 % 🥇 (Open)
~85 %
–
–
SWE-bench (Long Horizon)
~62 %
~69 % 🥇
~59 %
62,1 %
Coding-Ökosystem
Cursor · Cline · Kilo · OpenClaw
Claude Code · Cline · Kilo · Roo
Cursor · GitHub Copilot
Claude Code · Cline · Kilo
„NVIDIA Nemotron 3 Ultra ist mindestens so gut wie Opus 4.8 und GPT 5.5 für meinen Einsatz – und es ist ein Wunder, dass es open source ist. Der einzige Gap ist kein Vision-Support.“
— Jeremy Howard, Gründer fast.ai, auf X, 17. Juni 2026
05
Kostenlose API – So bekommst du Nemotron 3 Ultra in 5 Minuten
Drei Wege zu Nemotron 3 Ultra – von kostenlos bis Enterprise
NVIDIA gibt Entwicklern kostenlosen API-Zugang zu dutzenden gehosteten KI-Modellen – Llama, DeepSeek, Nemotron, Qwen, Mistral und mehr – durch seinen build.nvidia.com-Katalog. Der kostenlose NVIDIA-API-Key dauert etwa zwei Minuten, braucht keine GPU und keine Kreditkarte.
🆓 Kostenlos · Empfohlen für Start
Weg 1: OpenRouter Free API
$0 / 1M Tokens · Input & Output
1
Account auf openrouter.ai erstellen (E-Mail genügt)
2
API-Key generieren unter openrouter.ai/keys
3
Modell-ID: nvidia/nemotron-3-ultra-550b-a55b:free
4
Base URL: https://openrouter.ai/api/v1
⚠️ Limits: Rate-limitiert · 65.536 Max Output Tokens · Kein garantiertes SLA
⭐ Offizielle Quelle
Weg 2: NVIDIA build.nvidia.com
Kostenlos für Dev/Prototyping · Enterprise: NVIDIA AI Enterprise Lizenz
1
Gehe zu build.nvidia.com → „Get API Key“
2
NVIDIA Developer Program beitreten (kostenlos, nur E-Mail)
3
API-Key generieren: beginnt mit nvapi-
4
Base URL: https://integrate.api.nvidia.com/v1
5
Modell-ID: nvidia/nemotron-3-ultra-550b-a55b
⚠️ Limits: Kostenlos für Prototyping · Production = NVIDIA AI Enterprise erforderlich
🏠 Maximum Privacy
Weg 3: Self-Hosted (HuggingFace)
$0 Token-Kosten · Hardware: 8× 96GB GPUs (~$150K)
1
Weights: huggingface.co/nvidia/nemotron-3-ultra-550b-a55b
2
Framework: vLLM, SGLang, NIM Container oder Ollama
3
NVFP4-Variante für Blackwell GPUs empfohlen
4
Kein externer Datentransfer · Sovereign AI für regulierte Branchen
⚠️ Voraussetzung: 1,51 TB Gewichte · ~8× NVIDIA H100/H200 96GB GPUs
06
Code-Beispiele – Nemotron 3 Ultra in 5 Minuten einbinden
OpenAI-kompatible API – dein bestehender Code funktioniert sofort
OpenRouter und NVIDIAs API sind OpenAI-kompatibel – die meisten SDKs funktionieren einfach durch das Austauschen der Base URL. Du kannst deine bestehende OpenAI-Implementierung direkt gegen Nemotron 3 Ultra tauschen.
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="DEIN_OPENROUTER_API_KEY",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Schreibe eine Python-Funktion für Merge Sort mit Tests."
        }
    ],
    max_tokens=4096
)

print(response.choices[0].message.content)
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://integrate.api.nvidia.com/v1",
    api_key=os.environ["NVIDIA_API_KEY"],  # nvapi-...
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b",
    messages=[
        {
            "role": "system",
            "content": "Du bist ein Expert für Software-Engineering."
        },
        {
            "role": "user",
            "content": "Refaktoriere diesen Code und erkläre jeden Schritt."
        }
    ],
    max_tokens=8192,
    extra_body={
        "chat_template_kwargs": {"enable_thinking": True},
        "reasoning_budget": 16384  # Max Reasoning aktivieren
    }
)

print(response.choices[0].message.content)
const OpenAI = require("openai");

const client = new OpenAI({
  baseURL: "https://openrouter.ai/api/v1",
  apiKey: "DEIN_OPENROUTER_API_KEY",
});

async function callNemotron(prompt) {
  const response = await client.chat.completions.create({
    model: "nvidia/nemotron-3-ultra-550b-a55b:free",
    messages: [{ role: "user", content: prompt }],
    max_tokens: 2048,
    stream: false,
  });
  return response.choices[0].message.content;
}

callNemotron("Erkläre Transformer-Architektur in 5 Absätzen.")
  .then(console.log);
<html>
<body>
  <script src="https://js.puter.com/v2/"></script>
  <script>
    puter.ai.chat(
      "Analysiere diesen Code und erkläre Optimierungsmöglichkeiten.",
      {
        model: "nvidia/nemotron-3-ultra-550b-a55b",
        stream: false
      }
    ).then(response => {
      document.body.innerHTML = response;
    });
  </script>
</body>
</html>
// ✅ Kein API-Key · Kein Setup · Sofort nutzbar
// ⚠️ User-Pays Modell: Nutzer decken eigene KI-Kosten
07
Wann Nemotron 3 Ultra wählen – und wann Claude Opus 4.8
Die ehrliche Entscheidungsmatrix: Kein Modell gewinnt alles – aber für 80 % der Fälle ist Nemotron kostenlos die bessere Wahl
💰 Budget-sensitiv: $0 statt $25/1M Output-Tokens
🤖 High-Volume Agentic Pipelines: −30 % Kosten, 5× Speed
📁 Gesamte Codebases im Kontext: 1M Tokens nativ
🔒 Datenschutz: Self-Hosting in eigener Infrastruktur
⚙️ Multi-Agent Orchestrierung: PinchBench #1
🔧 Fine-Tuning auf eigenen Daten (NVIDIA Open License)
📊 RAG mit langen Dokumenten (RULER 1M: 95 %)
🏭 Sovereign AI: Regulierte Branchen ohne Cloud
⚡ Geschwindigkeit kritisch: 400+ Tok/s Throughput
🧪 Prototyping ohne Kosten
🏗️ Maximale SWE-Tiefe: NL2Repo 69,7 % (Nemotron: 48,9 %)
🖼️ Vision-Tasks: Bilder, Screenshots, UI-Analyse
⚙️ Komplexe Tool-Chains: Tool-Decathlon 59,9 %
🛠️ Claude Code Ecosystem: Best-in-class Harness
📜 SWE-Marathon: 26,0 % (Nemotron: 13,0 %)
🧬 Wissenschaftliche Recherche (außer Physik)
🏢 Enterprise: Bewährter SLA, Anthropic Support
🤝 Bestehende Claude-API-Integrationen ohne Migration
Die vollständige Nemotron 3 Familie – Nano, Super, Ultra im Vergleich
Nano
30B total · 3,2B aktiv
✅ Sub-Agenten · Edge-Deployment · Multimodal (Nano Omni)
3,3× schneller als Qwen3-30B-A3B
$0 / Token (OpenRouter Free)
Super
120B total · 12B aktiv
✅ Multi-Agent Workflows · IT-Ticket-Automation · Tool Calling
50%+ höhere Token-Generierung vs. Open-Model-Leader
$0 / Token (OpenRouter Free)
Flagship
Ultra
550B total · 55B aktiv
✅ Frontier Reasoning · Orchestrierung · Long-Context Agent
400+ Tok/s · 5× vs. GLM-5.1 · 1M Token Kontext
$0 (OpenRouter) · $2,20/1M Output (Paid)
Das Fazit
NVIDIA Nemotron 3 Ultra ist nicht das schlauste Modell der Welt. Kimi K2.6 und GLM-5.2 schlagen es auf dem Intelligence Index. Claude Opus 4.8 führt bei langen SWE-Agenten-Tasks. Aber Nemotron 3 Ultra ist das überzeugendste Gesamtpaket für Entwickler, die Agenten bauen: kostenlos über OpenRouter, 400+ Tokens pro Sekunde, 1 Million Token Kontext, vollständig open source, US-Unternehmen ohne China-Serverrisiko, und 30 % günstiger pro Agent-Task als die Konkurrenz. Für 80 % aller Coding-Agent-Workflows gibt es 2026 keinen rationalen Grund, $25 pro Million Output-Tokens zu zahlen – wenn dasselbe für $0 verfügbar ist. Die restlichen 20 % – komplexe Vision-Tasks, maximale SWE-Marathon-Tiefe, bewährte Enterprise-SLAs – gehören weiterhin Claude Opus 4.8. Hol dir den API-Key. Teste es. Dann entscheide.
FAQ – NVIDIA Nemotron 3 Ultra
Wie bekomme ich die kostenlose API für Nemotron 3 Ultra?
Es gibt drei Wege: (1) OpenRouter: openrouter.ai → Account erstellen → API-Key generieren → Modell: nvidia/nemotron-3-ultra-550b-a55b:free · $0 pro Token. (2) NVIDIA Build API: build.nvidia.com → Developer Program beitreten (kostenlos) → nvapi-Key generieren → base URL: https://integrate.api.nvidia.com/v1 · Für Prototyping kostenlos. (3) Puter.js: Keine API-Keys nötig, direkt im Browser nutzbar via js.puter.com/v2.
Was bedeutet „1 Million Token“ Kontext in der Praxis?
1 Million Tokens entsprechen ungefähr 750.000 Wörtern oder dem Inhalt von 5–10 durchschnittlichen Codebases. In Tests konnte Nemotron 3 Ultra eine Passphrase korrekt aus 600.000 Tokens entferntem Text extrahieren – in etwa 35 Sekunden. Auf dem RULER 1M Benchmark (Long-Context-Retrieval) erreicht das Modell 95 % Genauigkeit. Das ermöglicht vollständige Repository-Analysen, lange Dokument-RAG und Multi-Turn-Agent-Historien ohne Kontext-Verlust.
Ist Nemotron 3 Ultra wirklich besser als Claude Opus 4.8?
Für spezifische Metriken ja, für andere nein. Nemotron 3 Ultra ist klar besser bei: Throughput (400+ vs. ~120 Tok/s), Preis ($0 vs. $25/1M Output-Tokens), Kontextfenster (1M vs. 200K), Agent-Kosten (−30 %). Claude Opus 4.8 führt klar bei: SWE-bench Verified (~69 % vs. ~62 %), NL2Repo (69,7 % vs. 48,9 %), Tool-Decathlon (59,9 %), Vision-Support und Long-Horizon SWE-Marathon. Für High-Volume Agentic Workflows ist Nemotron die bessere Wahl. Für tiefe Software-Engineering-Aufgaben und Vision behält Claude die Führung.
Kann ich Nemotron 3 Ultra mit Claude Code, Cursor oder Cline nutzen?
Ja. Nemotron 3 Ultra ist kompatibel mit Claude Code, Cline, Kilo Code, OpenClaw, Goose und Roo – den wichtigsten Agentic-Coding-Frameworks. In OpenClaw ist Nemotron 3 Ultra sogar das Default-NVIDIA-Modell. Setze einfach die NVIDIA_API_KEY Umgebungsvariable, und der Provider aktiviert sich automatisch. Die OpenAI-kompatible API bedeutet: minimale Änderungen am bestehenden Code.
Was sind die Grenzen der kostenlosen OpenRouter-Version?
Die freie Version auf OpenRouter (nvidia/nemotron-3-ultra-550b-a55b:free) ist rate-limitiert. Der genaue Limit ist nicht publiziert und variiert je nach Auslastung. Der maximale Output liegt bei 65.536 Tokens (vs. 131.072 auf dem NVIDIA Build API). Es gibt keine garantierte Uptime oder SLA. Für Produktions-Deployments empfiehlt NVIDIA eine NVIDIA AI Enterprise Lizenz. Die bezahlte Version über OpenRouter kostet $0,50/1M Input und $2,20/1M Output – immer noch deutlich günstiger als Claude Opus 4.8 oder GPT-5.5.
Wie groß ist der Unterschied zwischen Nano, Super und Ultra?
Nano (30B total, 3,2B aktiv): für Sub-Agenten, Edge-Deployment, jetzt mit multimodalen Fähigkeiten (Nano Omni). Super (120B total, 12B aktiv): für Multi-Agent-Workflows und High-Volume-IT-Automatisierung – 50 %+ höhere Token-Generierung als Open-Model-Leader. Ultra (550B total, 55B aktiv): Flagship für komplexes Reasoning und Orchestrierung – 5× höherer Throughput als GLM-5.1. Alle drei sind über OpenRouter kostenlos zugänglich.
NVIDIA Nemotron 3 Ultra
Kostenlose KI API 2026
Open Source LLM
Agentic AI
OpenRouter
build.nvidia.com
1 Million Token
Claude vs Nemotron
NVIDIA NIM
MoE Modell
Kilo Code
Mamba Transformer
 061318944180